Proposta 3 — Arquivo de eventos + replay via query
Status: Brainstorming de consultoria — ver aviso metodológico Resolve: arquivamento de eventos além da retenção curta do Kafka, com replay pontual via consulta SQL Não resolve: dual-write nem DLQ em tempo real (ver Proposta 1, complementar a esta)
Contexto
Esta é a intenção real por trás do pedido inicial de "Event Sourcing": não reconstruir o estado de um agregado, mas conseguir arquivar eventos além da retenção curta do Kafka e reprocessar (replay) um evento ou uma janela de tempo específica via consulta SQL, quando necessário — sem a complexidade de um Event Store append-only. O modelo de referência trazido na discussão foi Kafka → Kinesis Firehose → Parquet (tabela Iceberg) → Athena → replay via query.
A Energisa já opera uma variante deste padrão hoje, dependente de Azure: Kafka → Kafka Connect Sink + Azure Runtime Integrator → Azure Data Lake Storage (retenção uniforme de 7 dias — risco R37 já registrado, com incidente real de perda de dado) → Databricks (Bronze/Silver/Gold) → SQL Warehouse/Delta Sharing → Power BI (ver engenharia-dados-adms.md). A variante abaixo é a alternativa Azure-independente, pedida explicitamente na discussão.
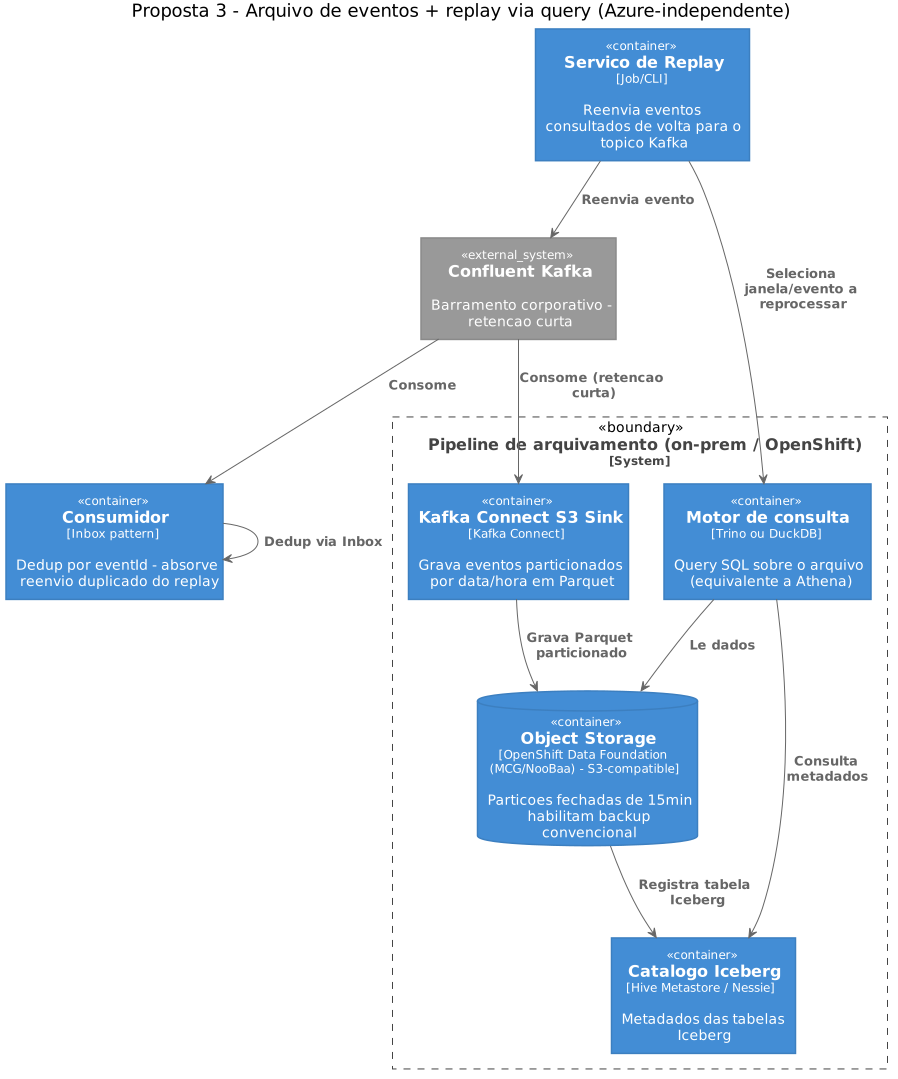
Diagrama C4 — Contêineres (variante Azure-independente)
Design patterns aplicados
| Padrão | Papel nesta proposta |
|---|---|
| Event Archive via CDC Sink | Kafka Connect S3 Sink move eventos do Kafka (retenção curta) para armazenamento de longo prazo, sem exigir mudança no produtor nem no consumidor original |
| Open Table Format (Iceberg) | Formato de tabela sobre Parquet com catálogo próprio — permite consulta SQL sem depender de um motor proprietário (equivalente aberto ao papel do Delta Lake no pipeline Azure existente) |
| Partições fechadas habilitando backup convencional | Mesma lógica já proposta por Castellani na Ata 10 para o Event Store do barramento: partições de 15min fechadas podem ser copiadas com backup de volume tradicional, ao contrário de um tópico Kafka em escrita contínua |
| Replay-by-requery | Diferença central frente a Event Sourcing (Proposta 2): não reconstrói o estado de um agregado — apenas seleciona e reenvia eventos brutos já publicados, como se tivessem chegado agora |
| Inbox / Idempotent Consumer | Necessário do lado do consumidor para absorver o reenvio do replay sem duplicar efeito — mesmo padrão da Proposta 1, reforçando que as duas propostas compartilham essa peça |
Cenários de aplicação
| Cenário | Proposta se aplica? |
|---|---|
| Precisa recuperar de uma falha de processamento passada, reprocessando uma janela de tempo específica | Sim — é o caso central |
| Auditoria ou consulta histórica via SQL, sem sobrecarregar a retenção do Kafka | Sim |
| Não há necessidade de reconstruir o estado atual de um agregado a partir do zero | Sim — é justamente o que diferencia esta proposta da Proposta 2 |
| Requisito é impedir que o dual-write aconteça em primeiro lugar, em tempo real | Não — isso é a Proposta 1; esta proposta assume que o evento já foi publicado com sucesso ao menos uma vez |
| Requisito de negócio exige reconstruir o estado de um agregado ponto-a-ponto no tempo | Não — volta a ser Event Sourcing genuíno (Proposta 2) |
Mecânica do sink: Iceberg vs Delta Lake (Databricks)
O componente "Kafka Connect S3 Sink" do diagrama acima esconde uma diferença de mecanismo entre as duas famílias de tabela aberta discutidas nesta e em outras sessões de consultoria — vale destrinchar, porque ela reforça (não substitui) a recomendação já registrada em "Alternativas de stack e trade-offs" abaixo com um "porquê" mecânico, não só de custo.
Iceberg Kafka Connect Sink (apache/iceberg, ou o fork databricks/iceberg-kafka-connect — mesma linhagem original da Tabular, adquirida pela Databricks em 2024; vale confirmar qual build empacotar antes de produção) escreve direto no object storage configurado, sem staging intermediário e sem depender de nenhum serviço gerenciado externo. A arquitetura interna separa dois papéis dentro do próprio cluster Connect: Workers (uma task por partição, convertem os registros Kafka em arquivos Parquet e os gravam no object storage, mas não commitam nada) e um Coordinator único, eleito entre as tasks, que só escuta um tópico de controle interno, agrupa os arquivos reportados pelos Workers a cada intervalo configurável e faz um commit atômico (uma nova snapshot) no catálogo Iceberg. O exactly-once vem de rastrear offsets em dois consumer groups paralelos (o padrão do Kafka Connect e um grupo próprio do sink). Resultado prático: o único requisito de colocation é entre o Connect e o object storage — já satisfeito pela topologia on-prem (OpenShift Data Foundation) desta proposta.
Databricks Delta Lake Sink Connector (mantido pela Confluent, disponível para Confluent Cloud/Platform) funciona de forma diferente: não escreve o par Parquet + transaction log do Delta diretamente. Ele faz staging dos registros num bucket S3 intermediário e só então comita esses dados na tabela via a API gerenciada de uma instância Databricks real. Duas implicações diretas para o caso da Energisa: (1) é append-only, e a integridade do bucket de staging é pré-requisito da garantia de exactly-once; (2) bucket de staging, tabela Delta e cluster Kafka precisam estar na mesma região de um serviço cloud gerenciado — ou seja, o mecanismo em si já pressupõe a dependência de Azure/Databricks que a variante "Azure-independente" desta proposta existe para evitar. Não é um detalhe de implementação secundário: é a mesma classe de dependência que já produziu o risco R37 (retenção uniforme de 7 dias na Landing, com perda de dado real) no pipeline hoje em produção.
| Iceberg (Kafka Connect Sink) | Delta Lake (Databricks Sink Connector) | |
|---|---|---|
| Onde grava | Direto no object storage configurado, sem intermediário | Staging em bucket S3 → commit via API gerenciada do Databricks |
| Dependência de serviço gerenciado | Nenhuma — só catálogo (Hive Metastore/Nessie) e object storage, ambos on-prem | Sim — exige instância Databricks real, mesma região do bucket e do Kafka |
| Encaixe com a topologia on-prem (OpenShift) desta proposta | Direto — mesmo desenho já registrado nesta proposta | Reintroduz a dependência Azure que a variante "Azure-independente" existe para evitar |
| Garantia de exactly-once | Commit atômico coordenado; offsets em dois consumer groups | Depende da integridade do bucket de staging; sem UPDATE/MERGE nativo |
| Maturidade/proveniência | Origem Tabular; hoje mantido tanto em apache/iceberg quanto em fork databricks/iceberg-kafka-connect |
Conector comercial da Confluent, documentado e suportado, mas atrelado ao ecossistema Databricks |
Essa mecânica é o motivo técnico — não só de custo ou de risco já materializado (R37) — para a recomendação de Iceberg + OpenShift Data Foundation registrada abaixo: o sink de Delta não é "Delta rodando on-prem", é, por desenho, um caminho que sempre termina numa instância Databricks gerenciada. Se a decisão for aceitar essa dependência, o pipeline ADLS→Databricks já em produção cumpre esse papel — não haveria motivo para adicionar um segundo conector fazendo a mesma coisa em paralelo.
Alternativas de stack e trade-offs
- Object storage: OpenShift Data Foundation (MCG/NooBaa) preferível a MinIO — MinIO community edition entrou em modo de manutenção em dezembro/2025 e foi arquivado em 25/04/2026 (distribuição apenas via source, sem binários oficiais nem novos patches), apesar de a Energisa já ter uma instância experimental de MinIO no datacenter da Paraíba (achado da Ata 10).
- Motor de consulta: Trino como equivalente mais próximo do Athena (cluster distribuído); DuckDB como alternativa mais leve, single-process, se o volume não justificar um cluster Trino dedicado.
- Catálogo Iceberg: exige um serviço à parte (Hive Metastore ou Nessie) — não é um componente opcional, é pré-requisito para qualquer consulta funcionar.
- Manutenção de jobs: Tekton/OpenShift Pipelines como opção nativa do OpenShift para compactação, expiração de snapshots Iceberg e outras rotinas de manutenção da tabela.
- Licenciamento: assim como a Proposta 1, depende de capacidade cuja licença não está confirmada — ver checklist de licenciamento (OpenShift Data Foundation e OpenShift Pipelines aparecem como "capacidade existe, licenciamento não confirmado").
- Variante Azure: se a dependência de Azure for aceitável, o pipeline já existente (ADLS → Databricks → SQL Warehouse) cobre o mesmo papel — mas carrega os riscos já documentados: retenção uniforme de 7 dias na Landing (R37, com incidente real de perda de dado) e custo do Databricks já questionado como achado de Fase 2.