Proposta 1 — Roteamento de Tópicos via Debezium SMT como Alternativa ao ksqlDB para Consolidação Multiempresa
Status: Brainstorming de consultoria — ver aviso metodológico
Resolve: fan-in multiempresa sem estado (o UNION que hoje roda no ksqlDB), redução de estruturas dedicadas, mitigação de R44
Recomendação: piloto controlado em 1–2 tabelas de baixo risco antes de qualquer expansão — ver seção final
Contexto
O ksqlDB, no barramento da Energisa, cumpre hoje uma função específica: consolidar, via UNION, os tópicos de CDC de nove bancos Oracle independentes (um por empresa do grupo) em tópicos unificados por tabela — não materialização de estado (0 tables em produção, 100% stream). Os números reais confirmam a matemática já sinalizada em risco: 322 streams, 265 queries persistentes (587 estruturas), 3 pods dedicados (atualizado em 02/09/2026 — eram 263 queries/585 estruturas em 09/07/2026, ver evidencias-producao-confluent-kafka.md, Seção A.11), crescendo proporcionalmente ao número de tabelas, não ao volume de eventos (ver hld-as-is-barramento.md e topologia-confluent-kafka-multiempresa.md, Diagrama 3).
Dois problemas distintos coexistem nesse desenho, e vale não confundi-los:
- Governança (R44): streams e queries do ksqlDB são criadas manualmente no Confluent Control Center, fora do pipeline de CI/CD — sem PR, sem versionamento, sem aprovação de Gestão de Mudanças. A infraestrutura do serviço ksqlDB é provisionada via pipeline; os objetos que ele executa, não.
- Capacidade: o modelo de "~10 estruturas por tabela" (9 streams de origem + 1 de consolidação) faz o custo de recursos crescer linearmente com o catálogo de tabelas — qualquer domínio novo com dezenas de tabelas eleva significativamente a carga dos 3 pods dedicados.
A pergunta que motivou esta proposta: o fan-in multiempresa (UNION de 9 tópicos por tabela) é, por natureza, uma operação sem estado — não exige um motor de streaming completo para existir. Ele pode ser resolvido na própria captura, via Kafka Connect, eliminando o ksqlDB da cadeia para esse caso específico.
Diagrama — Consolidação multiempresa sem ksqlDB
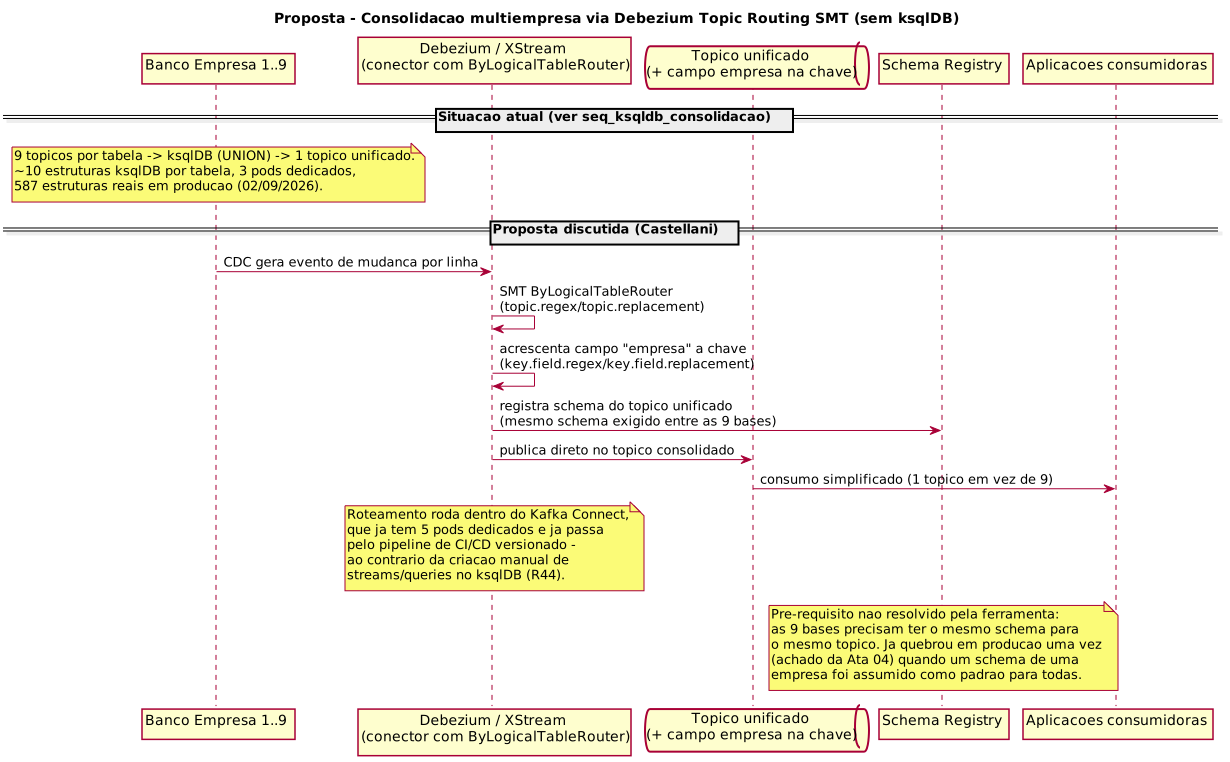
Design pattern aplicado
| Padrão | Papel nesta proposta |
|---|---|
Topic Routing SMT (io.debezium.transforms.ByLogicalTableRouter) |
Redireciona N tabelas físicas equivalentes (uma por empresa) para um único tópico lógico, ainda na captura CDC |
| Chave composta com discriminador | key.field.name/key.field.regex/key.field.replacement inserem um campo (ex. empresa) na chave do evento, evitando colisão entre PKs iguais de bases diferentes |
| Schema Registry como gate | O schema do tópico unificado precisa ser compatível entre as 9 origens — pré-requisito que a ferramenta não resolve sozinha (ver seção de riscos) |
Exemplo de configuração
Adaptado ao padrão de nomenclatura observado na evidência real de produção (oracle_source_xst_com_{empresa}.{SCHEMA}.{TABELA}, ex.: oracle_source_xst_com_spr.ATDESS.DESPACHO_OS, oracle_source_xst_com_ron.ATDERO.DESPACHO_OS — ver ksqldb_prd_latest.md):
transforms=RouteDespachoOS
transforms.RouteDespachoOS.type=io.debezium.transforms.ByLogicalTableRouter
transforms.RouteDespachoOS.topic.regex=oracle_source_xst_com_(\w+)\.(\w+)\.DESPACHO_OS
transforms.RouteDespachoOS.topic.replacement=barramento.despacho.despacho-os
transforms.RouteDespachoOS.key.field.name=empresa
transforms.RouteDespachoOS.key.field.regex=oracle_source_xst_com_(\w+)\.(\w+)\.DESPACHO_OS
transforms.RouteDespachoOS.key.field.replacement=$2
transforms.RouteDespachoOS.schema.name.adjustment.mode=avro
Isso precisa ser repetido por entidade (uma transformação por tabela lógica: DESPACHO_OS, EQUIPE, MEDIDOR, DESVIO_FCO etc.), encadeadas no mesmo conector ou distribuídas entre os conectores existentes conforme a topologia atual — não é um interruptor único que substitui o ksqlDB de uma vez.
Cenários de aplicação
| Cenário | Proposta se aplica? |
|---|---|
| Fan-in de N tópicos com o mesmo schema em um único tópico, sem transformação de negócio adicional | Sim — é exatamente o caso observado hoje (UNION simples por tabela) |
| Redução de estruturas dedicadas de processamento de stream (pods do ksqlDB) para esse padrão específico | Sim — a consolidação passa a rodar dentro do Kafka Connect já provisionado, sem cluster adicional |
| Trazer a criação/alteração do roteamento para dentro do pipeline de CI/CD versionado (mitigar R44) | Sim, para as tabelas migradas — a configuração do SMT é parte do manifesto do conector, já coberto pelo Azure DevOps |
Alguma das 265 queries do ksqlDB tiver filtro, CAST, join ou lógica de negócio além do UNION |
Confirmado, com texto completo (02/09/2026) — nenhuma das 265 queries mostra JOIN, GROUP BY, WINDOW/TUMBLING/HOPPING ou HAVING: a hipótese central de fan-in sem estado se sustenta. Mas PARTITION BY aparece em 261 das 265 (a análise truncada de 29/08 relatava zero — era limite de visibilidade do relatório original, não ausência real) e WHERE aparece em 32 das 265, das quais 30 filtram uma stream de controle compartilhada por NOM_TABELA antes de consolidar (lógica além do passthrough puro, embora ainda não um join) e 2 (wfm_ordem_servico) têm lógica de negócio real (janela de SLA). 12 queries usam STRUCT(...) para remontar campos, como já indicado na análise truncada. Ver seção "Validação completa" abaixo |
| Necessidade futura de estado (join com janela, agregação, view materializada) | Não — ver comparativo de alternativas abaixo |
Comparativo de alternativas para o que exigir estado no futuro
Nenhuma das nove tabelas de origem tem hoje um requisito documentado de estado (0 tables materializadas). Se isso mudar, a escolha de motor não deveria ser Debezium SMT (que só roteia, não processa com estado) — comparativo das opções discutidas:
| Alternativa | Perfil de recursos | Quando faria sentido | Ressalva principal |
|---|---|---|---|
| Debezium Topic Routing (esta proposta) | Mínimo — roda dentro do Connect já provisionado | Fan-in sem estado (caso atual) | Exige mesmo schema entre origens; não processa lógica de negócio |
| Apache Flink | Alto — cluster JVM dedicado (sugestão já feita pela Confluent, sem decisão) | Joins com janela, agregação, estado grande | Mesma classe de peso que o ksqlDB — troca de motor, não redução de custo |
| Kafka Streams | Baixo — biblioteca embarcada em microsserviço comum, sem cluster/MCP dedicado | Lógica pontual de estado, isolada por serviço | Exige código Java/Scala, não SQL declarativo |
| Materialize | Médio/alto — modelo cloud-first desde 2026; self-managed com licença a partir da v26 (edição gratuita limitada a 24 GiB RAM/48 GiB disco) | Views SQL sempre atualizadas sobre múltiplas fontes | Posicionamento cloud-managed conflita com ambiente on-premises (OpenShift/VxRail) da Energisa |
| RisingWave | Médio — self-hosted-first, mesma categoria do Materialize | Mesmo caso do Materialize, com menos dependência de SaaS externo | Menos maduro/adotado que Flink no mercado |
Riscos e ressalvas
- Migração de contrato de tópico. Mudar o nome do tópico de destino é uma mudança de contrato para qualquer consumidor que já lê os tópicos atuais — não é um switch em produção; exige plano de corte (tópico novo em paralelo, migração de consumidores, descomissionamento do antigo).
- Mudança de schema da chave. Inserir um campo na chave (
empresa) altera o schema Avro da chave — precisa ser validado contra a estratégia de compatibilidade do Schema Registry antes do rollout. - Pré-requisito de schema homogêneo não resolvido pela ferramenta — risco menor do que se temia, mas não zero (atualizado em 03/09/2026). O
ByLogicalTableRouterpressupõe que as tabelas roteadas tenham o mesmo schema — exatamente a premissa que já quebrou em produção uma vez (achado da Ata 04: schema Avro de uma empresa assumido como padrão para todas, corrigido depois com seleção explícita de campos em vez deSELECT *). Trocar de ferramenta não elimina a necessidade de um catálogo de divergências de schema entre as nove bases — só desloca onde esse cuidado precisa ser aplicado. O catálogo agora existe, ao menos para a famíliaoracle_source_xst_com_*: das 27 tabelas replicadas por empresa, 23 (85%) têm schema uniforme, e as 4 exceções são de causa conhecida e já contornada (ordem de coluna, não estrutura — ver "Validação completa" abaixo). Continua valendo checar cada tabela candidata antes de incluí-la num lote de migração, mas deixa de ser "risco desconhecido". - Escopo de cobertura — confirmado com texto completo (02/09/2026), ver seção seguinte. Esta proposta cobre o padrão de
UNIONpuro observado no relatório de produção — a maioria das 265 queries persistentes do ksqlDB (auditadas por completo, sem truncamento, em 02/09/2026). Mas há duas exceções conhecidas aoUNIONpuro que essa proposta, isolada, não cobre: reshaping de campo viaSTRUCT()(12 queries) e filtroWHERE NOM_TABELA = ...sobre uma stream de controle compartilhada (30 queries, alimentando 4 tabelas-alvo:ATENDIMENTO_OCORRENCIA_ENCRD,PROJETO,SGD_SIGOD,ORDEM_SERVICO). - Nenhum stakeholder pediu isso. Como nas propostas do domínio WFM/eForce e de Engenharia de Dados, esta ideia partiu de brainstorming de consultoria, não de um requisito articulado pela Energisa ou pela equipe de Kafka/Confluent — reforça a cautela de validar antes de propor como direção oficial.
Validação completa (02/09/2026) — texto integral das 265 queries, sem truncamento
Análise inicial (29/08/2026) sobre o texto truncado do relatório original (ksqldb_prd_latest.md, 263 queries) e, a partir de 02/09/2026, sobre o texto completo (ksqldb_report_20260902_081400.json, 265 queries, via SHOW QUERIES EXTENDED, sem truncamento — ver evidencias-producao-confluent-kafka.md, Seção A.11):
- Confirmado com texto completo: nenhuma ocorrência de
JOIN,GROUP BY,WINDOW,TUMBLING,HOPPINGouHAVINGem nenhuma das 265 queries — sustenta a hipótese de fan-in sem estado que motiva esta proposta.PARTITION BY, porém, aparece em 261 das 265 — a leitura de 29/08/2026 (zero ocorrências) era limite de visibilidade do relatório truncado, não ausência real; corrigido aqui. - A maioria segue o padrão
INSERT INTO <TABELA>_XST SELECT BEFORE AS BEFORE, AFTER AS AFTER...— passthrough puro do envelope Debezium, uma query por empresa de origem, com 8 ou 9 INSERTs por tabela-alvo (batendo com o número de empresas que têm aquela tabela), injetando o código da empresa como literal (<id> AS COD_EMPRESA, presente em 260 das 265 queries) e fazendoPARTITION BYpela chave reconstruída. É a assinatura de umUNIONimplementado como N INSERTs de fonte única — exatamente o caso que esta proposta cobre. - Exceção 1 (já identificada em 29/08, confirmada em 02/09): 12 queries usam
STRUCT(CODEMP := BEFORE->CODEMP, ...)para remontar campos do envelope, e 2 queries (wfm_ordem_servico) usamSELECT *a partir de outro stream, fora do padrão XST — com lógica de negócio real (uma filtra por janela de 8 horas antes do vencimento de SLA,UNIX_TIMESTAMP(...) < UNIX_TIMESTAMP() + 28800000). Refinando por tabela-alvo:PDA_XST(8 das 9 empresas usamSTRUCT()),SERVICO_XST(2 das 9),DESPACHANTE_XST(1 das 9) eRETORNO_OS_TEC_XST(1 das 6). Ainda é lógica de fonte única (não umJOINentre streams), mas é reshaping de campo — não seria coberta peloByLogicalTableRoutersozinho; exigiria SMTs adicionais (ex.ExtractField/ReplaceFieldencadeados) ou uma abordagem híbrida. - Exceção 2 (achado novo, só visível com texto completo): 30 queries filtram uma stream de controle compartilhada por nome de tabela. Em vez de uma stream dedicada por tabela-alvo, essas 30 queries partem de
controle_conector_barit_<código>(mesma família de tabela de controle/auditoria do conectoritg_crp, Seção A.9 deevidencias-producao-confluent-kafka.md), aplicamWHERE NOM_TABELA = '<tabela-alvo>'e fazemPARTITION BYpela chave de registro. Produzem 4 tabelas-alvo:ATENDIMENTO_OCORRENCIA_ENCRD(4 queries),PROJETO(8),SGD_SIGOD(9) eORDEM_SERVICO(9). Para essas 4 tabelas, oByLogicalTableRoutersozinho não é suficiente — ele roteia por nome de tópico/tabela físico, não por um filtro de conteúdo (NOM_TABELA) dentro de uma stream compartilhada; migrar essas 4 tabelas exigiria replicar essa lógica de filtro no Kafka Connect (ex. um SMT de filtro por conteúdo, ou uma reestruturação da fonte antes da captura) ou mantê-las no ksqlDB e migrar só as tabelas do padrão limpo. - Limite da validação de 29/08/2026 (resolvido em 02/09/2026): o relatório original truncava todas as 263 queries em ~62-63 caracteres, cortando o texto antes da cláusula
FROMna maioria dos casos. O scriptksqldb-queries-report.sh, prometido pela Energisa e recebido em 02/09/2026 (ksqldb_report_20260902_081400.json), trouxe ostatementTextcompleto (viaSHOW QUERIES EXTENDED) das agora 265 queries — nenhuma permanece truncada (a maior tem 12.624 caracteres). Os achados acima (PARTITION BYem 261/265, as duas exceções deSTRUCT()e de filtro porNOM_TABELA) já refletem essa auditoria completa; não há mais lacuna de truncamento a fechar nesta frente. - Eliminação de tópicos — validado via consumer groups (29/08/2026). A proposta não só reduz estruturas do ksqlDB, elimina tópicos: hoje, cada tabela consolidada tem N tópicos por empresa alimentando 1 tópico unificado; com o roteamento via SMT, só o tópico unificado passa a existir. Cruzando os 235 tópicos de origem das 33 tabelas consolidadas com os consumer groups já presentes no relatório de tópicos: 202 têm como único consumidor o próprio ksqlDB (elimináveis sem dependência externa conhecida), 15 não têm nenhum consumer group ativo (achado à parte, não presumir se é seguro ou não sem investigar) e 18 — os 9 tópicos de
DESPACHO_OSe os 9 deOS_DIGITACAO, um por empresa — têm um segundo consumidor confirmado e ativo (energisa-kafka-dls-sink-prd), que não aparece em nenhum conector documentado. Detalhamento completo emevidencias-producao-confluent-kafka.md, seção A.10. Implicação direta para o piloto:DESPACHO_OSeOS_DIGITACAOnão devem entrar na primeira leva de tabelas migradas, mesmo passando no critério de padrão de query limpo — ver seção "Segunda fase" abaixo. - Schema Registry — checado e descartado como motivo adicional de exclusão (03/09/2026). O export completo do Schema Registry mostra
DESPACHO_OSeOS_DIGITACAOcomschema_iddistinto por empresa nas 9 distribuidoras — à primeira vista, indício de schema divergente. Não é: comparando o conteúdo real das colunas (viaddl_completodos streams do ksqlDB, já recebido em 02/09/2026), as 9 empresas têm exatamente a mesma estrutura nas duas tabelas — oschema_iddiferente é uma peculiaridade deste Schema Registry, não evidência de schema diferente. Isso não muda a exclusão deDESPACHO_OS/OS_DIGITACAOdo primeiro lote — o motivo continua sendo o consumidor extraenergisa-kafka-dls-sink-prd(A.10) — mas descarta divergência de schema como um segundo motivo. Detalhe completo emevidencias-producao-confluent-kafka.md, Seção A.12. - Padrão de schema nas 27 tabelas replicadas por empresa (03/09/2026) — reduz o tamanho do risco de schema homogêneo. A mesma comparação de
ddl_completopor trás do achado acima, repetida para toda a famíliaoracle_source_xst_com_*(não só as duas tabelas do piloto): 23 das 27 tabelas têm estrutura de coluna idêntica em todas as empresas presentes; as 4 exceções (DESPACHANTE,PDA,RETORNO_OS_TEC,SERVICO) não têm campo faltando, sobrando ou de tipo diferente — divergem só em ordem de coluna entre um subconjunto pequeno de empresas (hipótese mais provável, não confirmada com a Energisa:ALTER TABLE ADD COLUMNaplicado em momentos diferentes por base Oracle). São exatamente as mesmas 4 tabelas que já apareciam acima usandoSTRUCT()em vez de passthrough puro — antes sem explicação de causa, agora com uma: oSTRUCT()está lá para normalizar a ordem de coluna. Detalhe completo, com a tabela das 4 exceções, emevidencias-producao-confluent-kafka.md, Seção A.12.
Por que piloto, não migração completa
A Event Sourcing clássica da Proposta 2 de WFM/eForce foi desenhada por completude e explicitamente não recomendada por desproporção entre complexidade e problema real. Esta proposta é mais barata — reaproveita infraestrutura já provisionada (Kafka Connect) em vez de introduzir peça nova — mas carrega um risco que não é de complexidade, e sim de dado: o pré-requisito de schema homogêneo entre nove bases legadas com décadas de divergência. Por isso a recomendação não é "substituir o ksqlDB", é validar em escala pequena antes de generalizar.
Recomendação
Não propor substituição integral do ksqlDB de uma vez. Sugerir um piloto controlado: escolher 1–2 tabelas de baixo risco (poucas divergências de schema conhecidas entre as empresas, sem consumidores críticos), migrar via ByLogicalTableRouter em paralelo ao tópico consolidado atual, medir redução real de estruturas/recursos, e só então avaliar expansão. Antes do piloto, auditar o DDL completo das queries ksqlDB correspondentes a essas tabelas para confirmar que não há lógica além do UNION. Flink (ou Kafka Streams, para casos pontuais) permanece como opção para qualquer necessidade futura de estado — não como substituto do papel que o ksqlDB cumpre hoje.
Dado o achado de consumer groups acima, o piloto inicial deve escolher tabelas fora de DESPACHO_OS e OS_DIGITACAO — mesmo sendo duas das tabelas com padrão de query mais limpo, elas carregam uma dependência de tópico já confirmada (ver "Segunda fase" abaixo) que não existe nas outras 26 tabelas do grupo limpo. Pelo mesmo critério de cautela, também não escolher ATENDIMENTO_OCORRENCIA_ENCRD, PROJETO, SGD_SIGOD ou ORDEM_SERVICO na primeira leva — essas quatro seguem o padrão de filtro por NOM_TABELA sobre stream compartilhada identificado na validação completa (02/09/2026, ver acima), que o ByLogicalTableRouter sozinho não cobre.
Segunda fase — perguntas em aberto (após o piloto)
Antes de estender o roteamento via Debezium para DESPACHO_OS e OS_DIGITACAO — ou qualquer outra tabela onde uma checagem equivalente de consumer groups encontre o mesmo padrão — as seguintes perguntas precisam de resposta da Energisa:
- O que é o consumer group
energisa-kafka-dls-sink-prd? Ele lê hoje, diretamente, os 9 tópicos por empresa deDESPACHO_OSe os 9 deOS_DIGITACAO(e, no total, 209 tópicos brutos por empresa em toda a produção — nenhum deles já consolidado pelo ksqlDB). Não corresponde a nenhum conector do relatório de Kafka Connect nem a nenhum ator documentado neste assessment. Hipótese de trabalho, não confirmada: um sink para data lake/warehouse operando em paralelo ao ksqlDB. Verevidencias-producao-confluent-kafka.md, seção A.10. - Esse consumidor pode ser reapontado para o tópico unificado? Se ele só precisa dos dados por empresa para fins de rastreabilidade/particionamento no destino, o campo
empresajá embutido na chave do evento consolidado (ver seção "Exemplo de configuração" acima) pode ser suficiente — mas isso depende de como ele está implementado, algo que a consultoria não tem visibilidade sem identificar o dono do processo. - Existem outros consumidores equivalentes, ainda não identificados, para as demais 26 tabelas do grupo "limpo"? A checagem de consumer groups feita em 29/08/2026 cobriu só os 235 tópicos de origem das 33 tabelas hoje consolidadas pelo ksqlDB — não é uma auditoria completa de todos os tópicos do barramento. Antes de expandir o piloto além das primeiras 1–2 tabelas, repetir essa checagem para cada tabela candidata.
Ver também
- Topologia Confluent Kafka e Consolidação Multiempresa — Diagrama 3, origem do achado e da matemática de estruturas por tabela
- HLD As-Is — Barramento Confluent Kafka — números consolidados de produção e achado R44
- Matriz de riscos consolidada — R44 (ksqlDB fora do pipeline de CI/CD)
- Evidências de Produção — Barramento Confluent Kafka — relatório real de streams/queries/tópicos
- Debezium Documentation — Topic Routing — referência oficial do SMT